La IA en QA: un potenciador que necesita método
La IA rinde mejor cuando trabaja dentro de una metodología clara. Qué cambió en el QA con IA, qué recomiendan los fabricantes y cómo lo abordamos en Flagare.
Cuando se habla de inteligencia artificial en el desarrollo de software, casi siempre se piensa en escribir código. Sin embargo, el aseguramiento de calidad (QA) es parte del mismo proceso, y también ha incorporado herramientas de IA para diseñar casos de prueba, generar pruebas automatizadas, analizar fallas y mantener los scripts al día.
Esa incorporación no ha sido lineal. En pocos años, la forma de usar la IA en pruebas cambió tanto como los propios modelos, y con ella también la manera de pedirle resultados. Este artículo recorre esa evolución, revisa qué recomiendan hoy los fabricantes de los modelos, explica la metodología que utiliza Flagare y plantea una idea central: la IA rinde mejor cuando trabaja dentro de una metodología clara.
De generar más pruebas a generar mejores pruebas
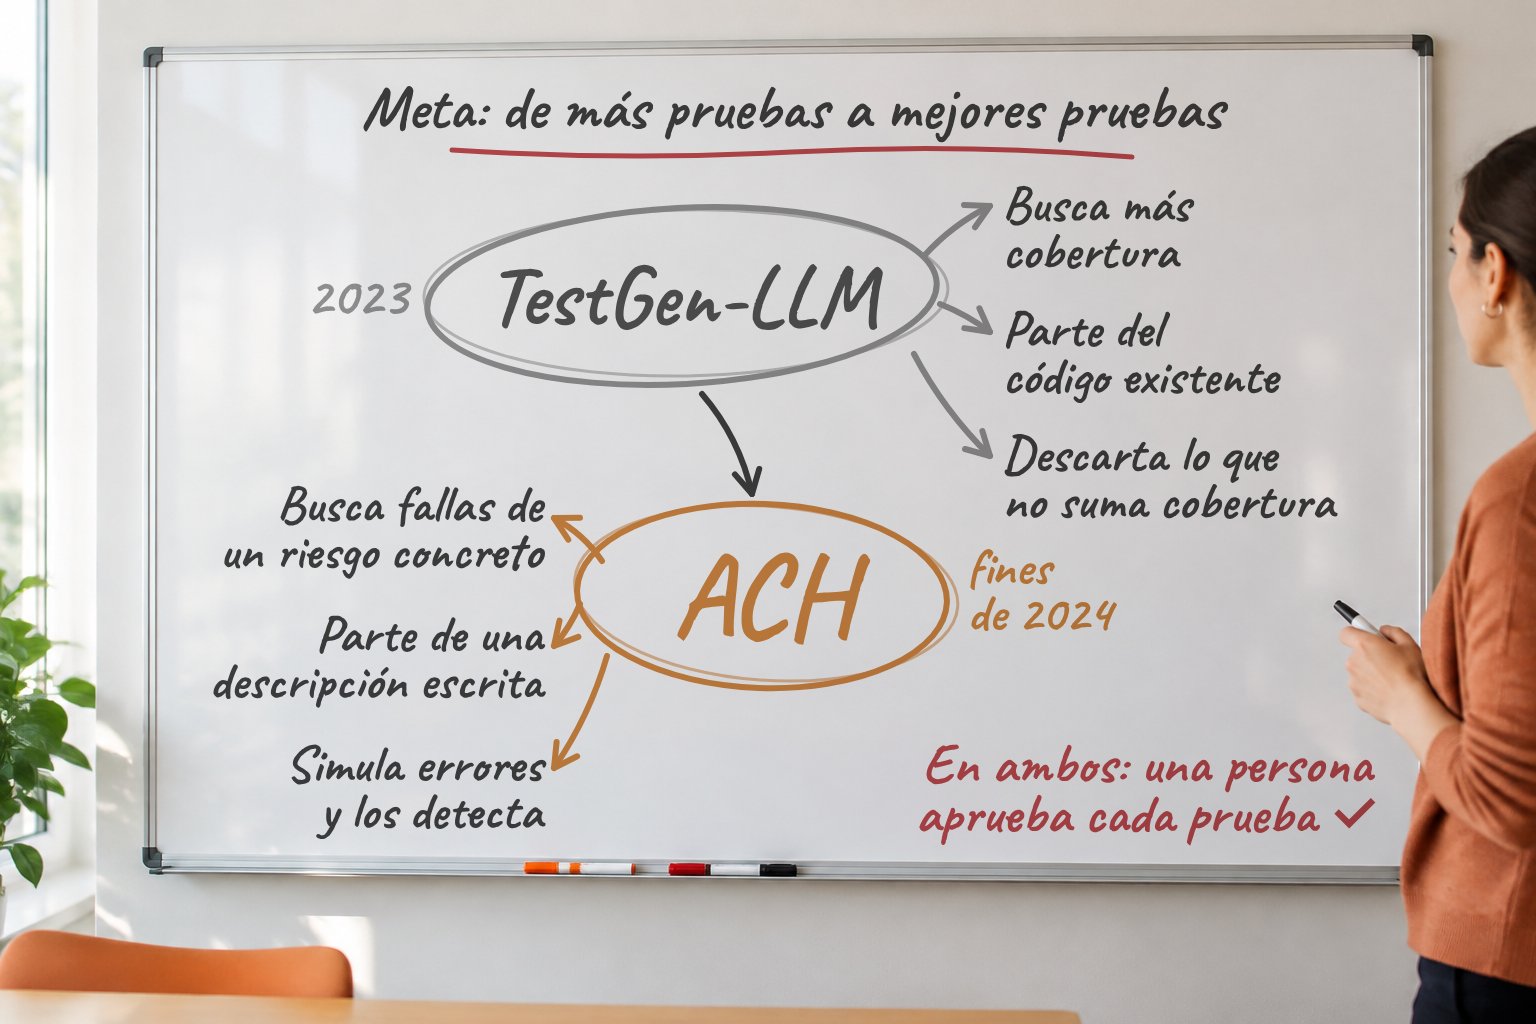
Uno de los casos mejor documentados es el de Meta. En 2023, la empresa usó una herramienta interna llamada TestGen-LLM para ampliar las pruebas unitarias de Instagram y Facebook. Los resultados se publicaron en la conferencia académica FSE 2024. En una evaluación sobre Reels y Stories, solo una de cada cuatro pruebas generadas logró aumentar la cobertura, es decir, probar partes del código que las pruebas existentes no revisaban. Aun así, los ingenieros aprobaron el 73 % de las recomendaciones que llegaron a revisión.
Para llegar a esa revisión, cada prueba generada debía superar filtros automáticos que exigían que se construyera sin errores, funcionara correctamente en todas sus ejecuciones y aportara cobertura nueva. Las que no cumplían se descartaban, y las que sí cumplían de todos modos necesitaban la aprobación final de una persona.
A fines de 2024, Meta presentó en FSE 2025 un nuevo sistema que cambió su enfoque: Automated Compliance Hardening o ACH por sus siglas en inglés. En lugar de buscar más cobertura, ACH trabaja a partir de un riesgo concreto. El sistema recibe una descripción escrita de ese riesgo, por ejemplo, un posible problema de privacidad. Con esa descripción, introduce a propósito errores parecidos en una copia del código y luego genera pruebas capaces de detectarlos.
Este enfoque permitió conservar pruebas que el método anterior habría descartado. Casi la mitad de las pruebas que generó ACH no aumentaba la cobertura, por lo que un filtro como el de TestGen-LLM las habría eliminado. Sin embargo, esas pruebas sí detectaban los errores introducidos. Los ingenieros, nuevamente, aprobaron el 73 % de las pruebas que revisaron.
El cambio de fondo es que la IA pasó de producir pruebas en volumen a buscar fallas a partir de un objetivo bien descrito.
Las encuestas a la industria muestran una evolución parecida. El World Quality Report, que Capgemini y OpenText publican cada año a partir de una encuesta a más de 2000 ejecutivos de 22 países, registra que la proporción de organizaciones que no usaban IA generativa en calidad bajó del 31 % en 2023 al 11 % en 2025. También cambió su uso. La IA dejó de concentrarse en analizar resultados, como reportes de defectos, y hoy se usa sobre todo para diseñar casos de prueba y refinar requisitos.
Eso sí, no todas las organizaciones obtienen los mismos beneficios. En promedio, los encuestados reportan un 19 % más de productividad, pero en un tercio de ellas casi no ha habido cambios. Entre los principales obstáculos, el informe menciona la dificultad de integrar la IA con los procesos existentes, la desconfianza en respuestas que pueden ser inventadas y la falta de experiencia en IA, que reconoce la mitad de las organizaciones. Es decir, adoptar la herramienta no basta; los resultados dependen de cómo se integra al trabajo del equipo.
Nuevos modelos, nuevas formas de comunicarse
A medida que los modelos cambiaron, también cambió la forma de darles instrucciones. Con los modelos de 2023, la redacción de la instrucción tenía mucho peso. Un estudio publicado en marzo de 2026 en la revista Empirical Software Engineering evaluó más de 200 000 pruebas generadas por modelos de esa época, como GPT-4, y encontró que guiarlos paso a paso (listar las funciones, cubrir los casos básicos y luego los casos límite) producía pruebas más legibles y con mejor cobertura.
Los modelos actuales funcionan de otra manera. Muchos razonan internamente antes de responder, por lo que ya no necesitan que se les explique cómo pensar. Lo que sí necesitan es contexto: qué se espera del software, qué reglas se aplican y cómo se comprueba que el resultado es correcto.
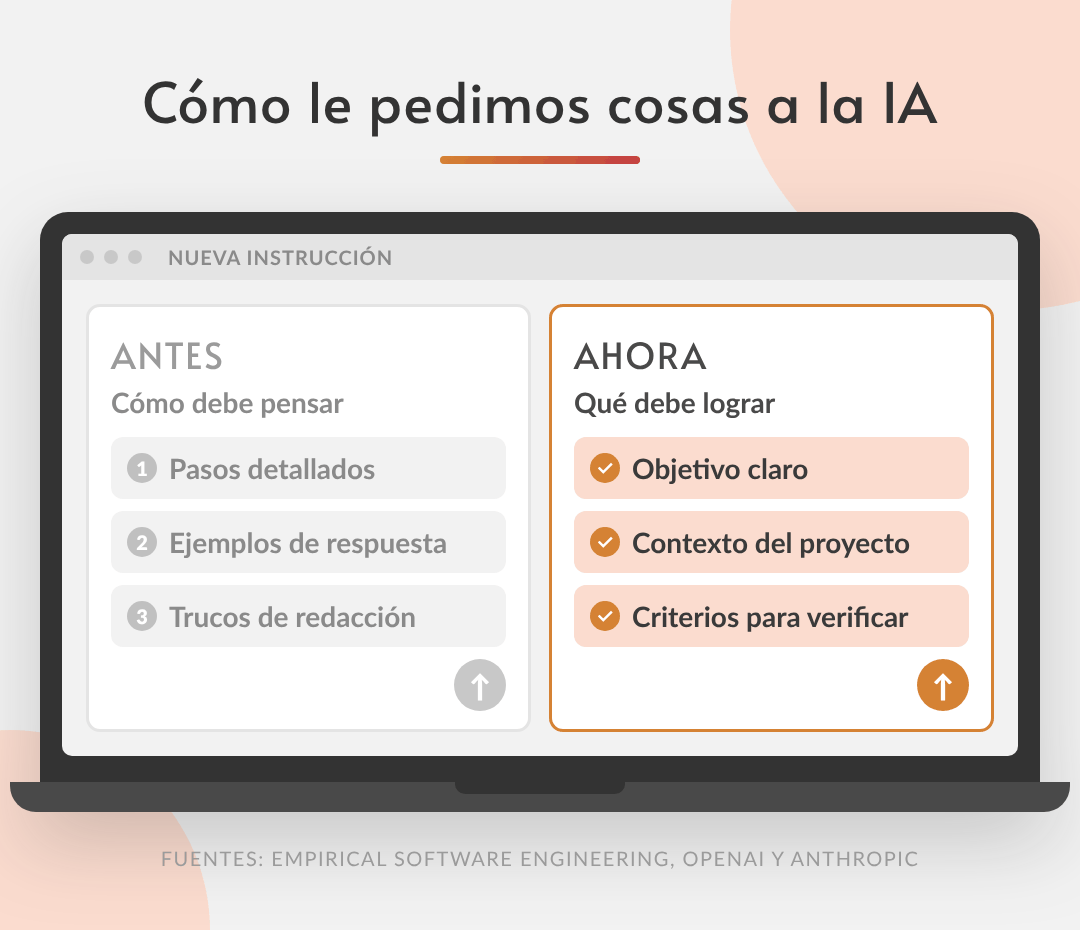
De esa necesidad surgieron nuevas formas de especificar. Una de las más extendidas es AGENTS.md, un formato abierto presentado por OpenAI en agosto de 2025 y posteriormente incorporado a la Agentic AI Foundation, creada por OpenAI, Anthropic y Block bajo la Linux Foundation.
Este archivo funciona como un manual para los agentes de IA dentro de cada proyecto, ya que reúne las convenciones del equipo, los pasos de compilación y los requisitos de prueba. Hoy lo admiten herramientas como Cursor, Gemini CLI y GitHub Copilot. Claude Code utiliza un archivo equivalente, CLAUDE.md. El caso de ACH en Meta va en la misma línea, porque su punto de partida es una descripción escrita del riesgo que se quiere controlar.
Lo que no cambió en ninguna de estas etapas es la necesidad de alguien que orqueste y revise. En los dos sistemas de Meta, ninguna prueba llegó a producción sin la aprobación de un ingeniero. El estudio de Empirical Software Engineering también advierte que los modelos inventaron funciones y dependencias, por lo que sus autores recomiendan combinar la generación con validación automatizada. Una instrucción mejor escrita reduce los errores, pero no los elimina.
Qué recomiendan los fabricantes
OpenAI y Anthropic mantienen guías actualizadas sobre cómo trabajar con sus modelos, y varias de sus recomendaciones se aplican directamente a las pruebas.
OpenAI: guía para modelos de razonamiento
- Dar instrucciones simples y directas. Estos modelos entienden bien las indicaciones breves y claras.
- No pedir que "piense paso a paso". Ya razonan internamente, así que esa instrucción es innecesaria y puede empeorar el resultado.
- Usar delimitadores. Las secciones o etiquetas ayudan a separar las partes de la instrucción, como el código, los requisitos y los criterios de aceptación.
- Ser específico con el objetivo. Conviene definir qué es un resultado exitoso y pedirle al modelo que itere hasta cumplirlo.
- Elegir el modelo según la tarea. OpenAI propone usar modelos de razonamiento para planificar y revisar, y modelos más rápidos para ejecutar tareas bien definidas.
Anthropic: buenas prácticas para Claude Code
- Contarle lo que no puede ver. El modelo lee bien el código, pero no conoce las decisiones del equipo, los procesos no documentados ni la configuración del entorno de pruebas.
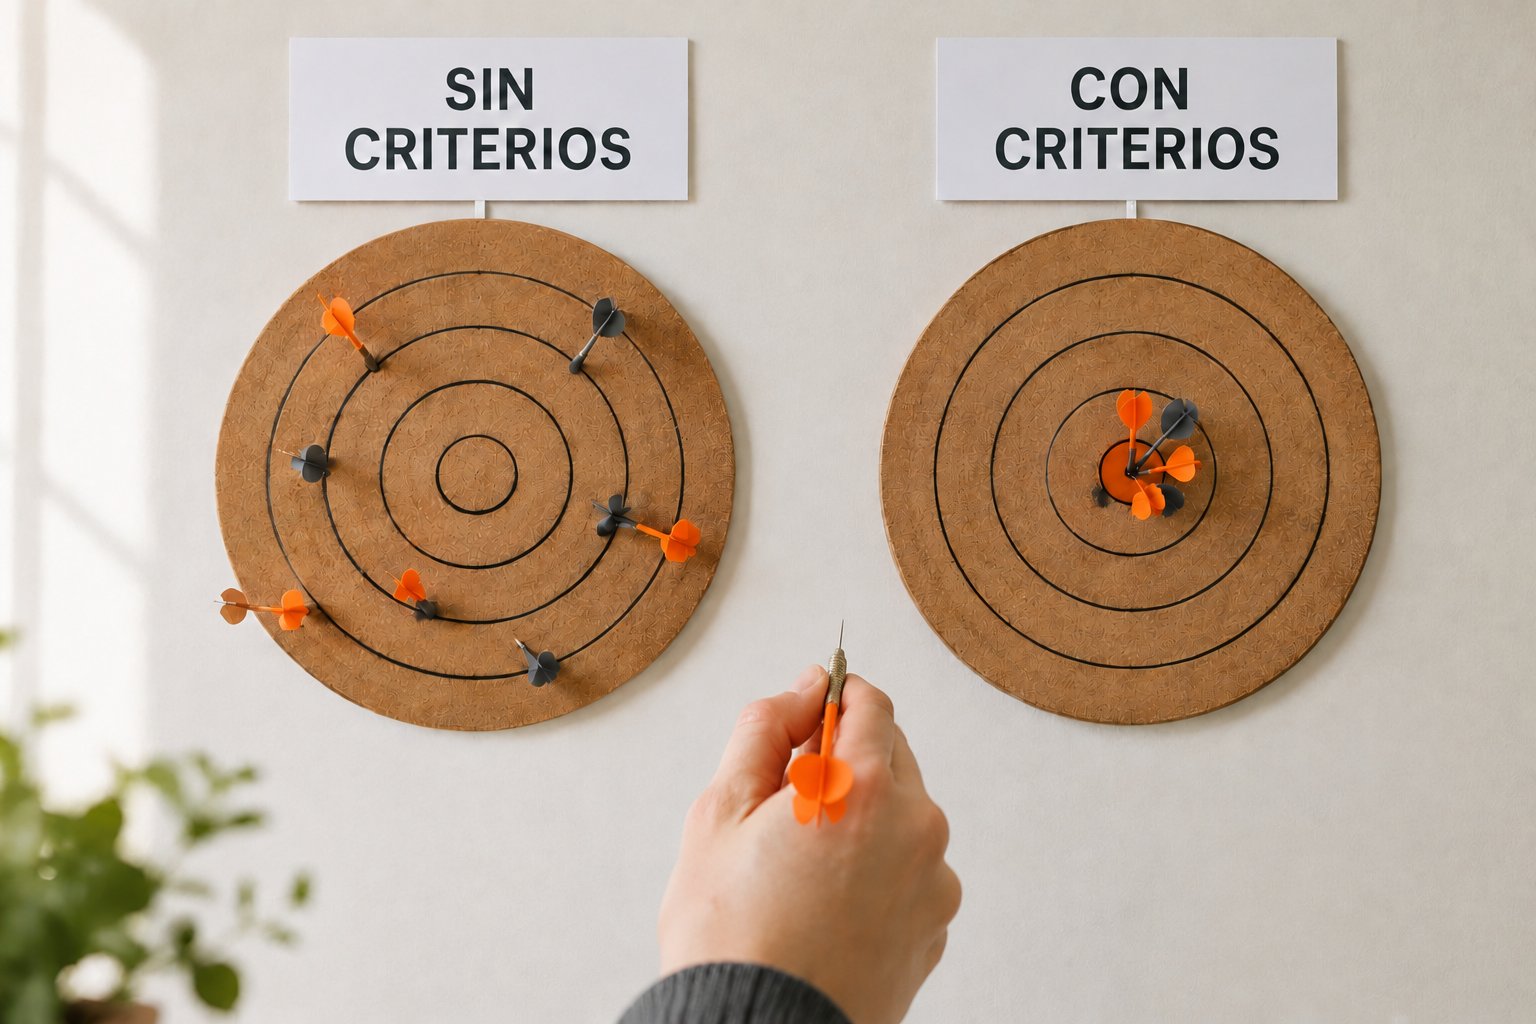
- Darle una verificación que responda "pasa" o "falla". Sin algo que ejecutar, el modelo solo puede guiarse por si el trabajo parece terminado.
- Pedir evidencia. Solicitar el comando ejecutado y su resultado, porque "todas las pruebas pasan" por sí solo no entrega mucha información.
- Revisar con un agente que no escribió el código. Un revisor que no vio la conversación original no se deja llevar por el razonamiento que lo produjo.
- Acotar la revisión. Si se le pide buscar problemas sin límites, siempre encontrará algo, e incluso propondrá pruebas para casos que no pueden ocurrir.
Cómo se ve en la práctica
Si damos una instrucción genérica, el modelo prácticamente está adivinando. Por ejemplo:
Genera pruebas para el módulo de pagos.
Una instrucción que aplica las recomendaciones que vimos le entrega un objetivo verificable al modelo:
Genera pruebas unitarias para la función que valida medios de pago. Criterios de aceptación: rechazar tarjetas vencidas, validar el largo del código de seguridad según el tipo de tarjeta y aceptar solo números válidos según el algoritmo de Luhn. Escribe las pruebas a partir de estos criterios, no del código actual. Ejecútalas, muéstrame el comando y el resultado, y no modifiques las pruebas para que pasen.
La segunda versión separa el objetivo de los criterios, aporta el contexto que el código no muestra y exige evidencia. También evita un riesgo frecuente, ya que, si las pruebas se escriben a partir del código, pueden dar por bueno un error que ya existe.
De la teoría a la práctica: nuestra metodología en Flagare
En Flagare entendemos que la calidad del software no depende únicamente de que una funcionalidad opere según lo esperado. Una solución también debe comportarse correctamente desde el punto de vista técnico y cumplir con los controles de seguridad definidos para su operación.
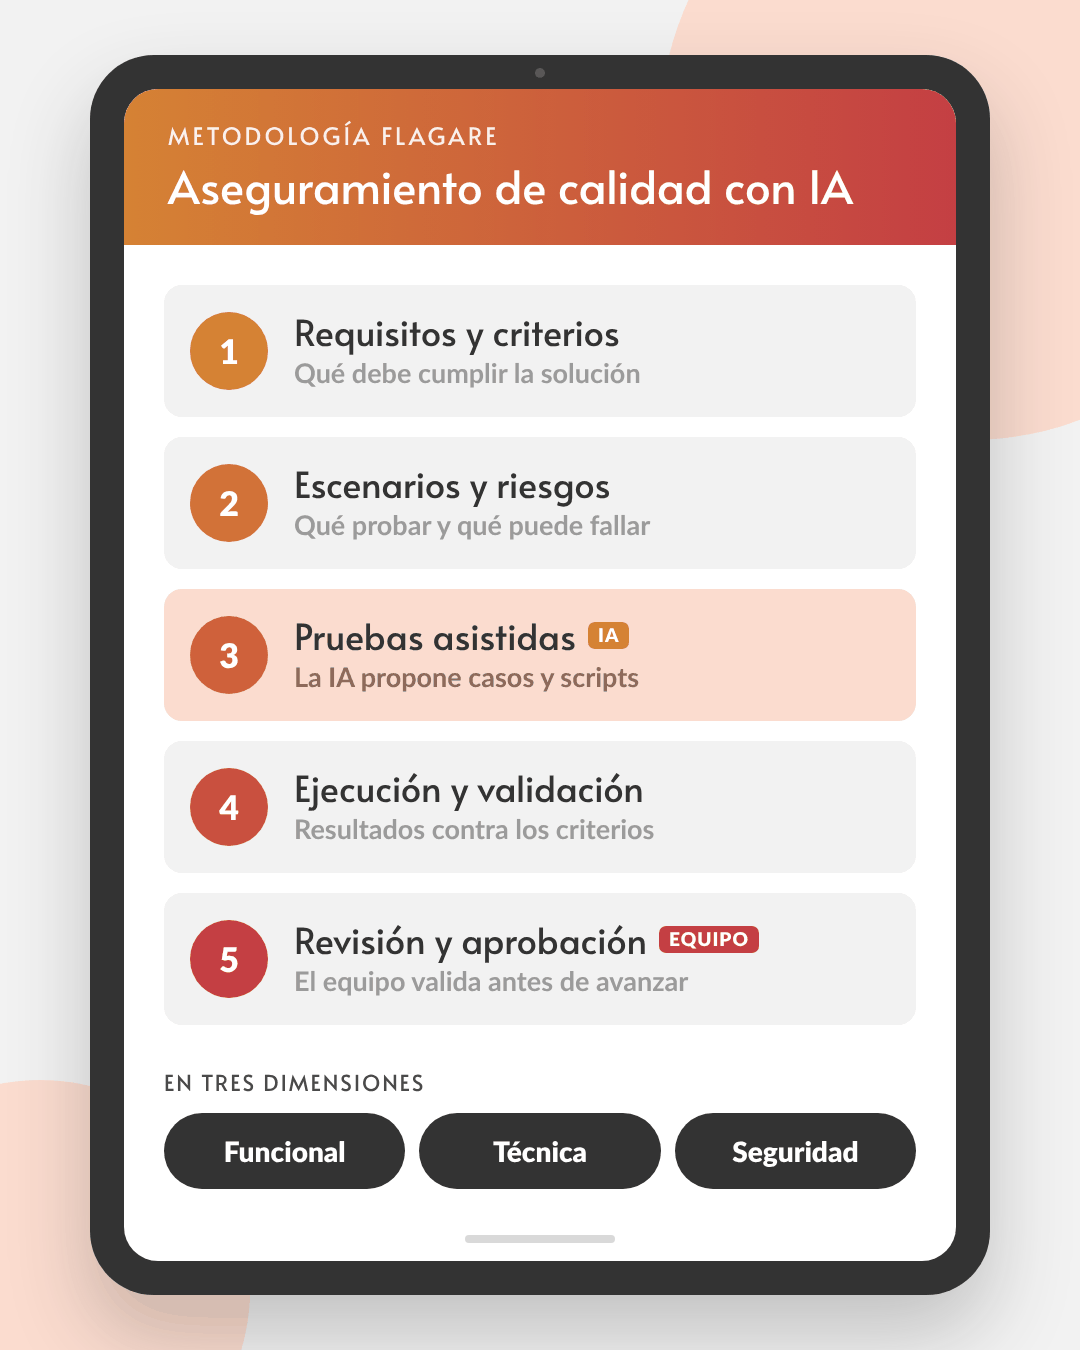
Por esta razón, nuestro enfoque de aseguramiento de calidad contempla tres dimensiones complementarias: funcional, técnica y seguridad. La inteligencia artificial se incorpora como una herramienta de apoyo para ampliar la capacidad de análisis, identificar escenarios de prueba y facilitar su automatización, siempre dentro de un proceso con criterios definidos y resultados verificables.
Nuestra metodología se estructura en cinco etapas:
- Definición de requisitos y criterios de aceptación. Antes de iniciar el desarrollo, establecemos las reglas de negocio, los comportamientos esperados, los requisitos técnicos y las condiciones de seguridad que debe cumplir la solución. Estos elementos constituyen la base sobre la cual se diseñarán y evaluarán las pruebas.
- Identificación de escenarios y riesgos. Organizamos los escenarios de prueba en tres dimensiones:
- Pruebas funcionales: verifican que las funcionalidades cumplan los requisitos del negocio, incluyendo flujos principales, validaciones, reglas de negocio, condiciones excepcionales y casos límite.
- Pruebas técnicas: evalúan el comportamiento de los componentes y sus integraciones, considerando contratos de API, manejo de errores, persistencia de datos, rendimiento y estabilidad, según las características de la solución.
- Pruebas de seguridad: comprueban los controles de autenticación, autorización, protección de datos, validación de entradas y manejo seguro de información sensible, de acuerdo con los riesgos identificados.
- Diseño y generación de pruebas asistidas por IA. A partir de los requisitos y escenarios definidos, utilizamos inteligencia artificial para apoyar la elaboración de casos de prueba, identificar situaciones no consideradas inicialmente y generar scripts automatizados cuando corresponde. Cada prueba debe responder a un objetivo concreto y contar con un resultado esperado que permita determinar su cumplimiento.
- Ejecución y validación de resultados. Las pruebas se ejecutan en entornos controlados, contrastando sus resultados con los criterios de aceptación establecidos. Cuando las características del proyecto lo permiten, las verificaciones automatizadas se integran a los procesos de integración continua, manteniendo evidencias que faciliten el seguimiento y análisis de defectos.
- Revisión y aprobación. Los resultados obtenidos se someten a revisión técnica y funcional, considerando también los hallazgos de seguridad. El equipo responsable determina la pertinencia de las pruebas, evalúa los riesgos pendientes y valida que los resultados cumplan con los criterios definidos antes de avanzar a las siguientes etapas del ciclo de desarrollo.
Esta metodología busca que la inteligencia artificial contribuya a mejorar la profundidad y eficiencia del aseguramiento de calidad, sin reemplazar el criterio de los profesionales responsables.
El objetivo no es generar más pruebas, sino contar con pruebas relevantes, trazables y verificables, capaces de demostrar que una solución cumple con las necesidades del negocio, funciona correctamente desde el punto de vista técnico y mantiene los controles de seguridad requeridos.
La IA potencia lo que ya está definido
La evolución de los últimos años nos indica que la IA es un potenciador. Cuando trabaja dentro de una metodología con reglas claras, puede entregar pruebas útiles y resultados confiables. Los mejores resultados de Meta se vieron cuando la IA tenía un objetivo preciso, filtros automáticos y una persona que aprobaba el resultado final.
La IA amplifica las capacidades de un equipo, pero no las reemplaza. Si desde el inicio no está claro qué debe hacer el software, qué documentación necesita el modelo y cuáles son los límites de cada proceso, la IA no tiene cómo suplir esa falta. Producirá pruebas, pero nadie podrá asegurar que prueben lo correcto.
Por eso, el trabajo empieza antes de pedirle algo a la IA. Una práctica concreta es definir el plan de pruebas antes de desarrollar, como parte de la especificación. Si el plan deja escrito qué se quiere probar, con sus escenarios, casos límite y resultados esperados, la IA tiene un marco contra el cual construir y verificar. Sin ese plan, las pruebas se hacen a ciegas, y la IA completa con supuestos lo que nadie le definió. Los criterios de aceptación, la documentación que recibe el modelo y la persona que revisará los resultados forman parte de ese mismo plan.
¿Tu equipo quiere usar IA en sus pruebas sin perder el control de la calidad? En Flagare podemos acompañarlos desde la definición del plan de pruebas.
Escríbenos y comencemos con tu nuevo desafío.
Fuentes
- Alshahwan et al. (Meta), Automated Unit Test Improvement using Large Language Models at Meta, Proceedings of the 32nd ACM International Conference on the Foundations of Software Engineering (FSE 2024), ACM.
- Foster et al. (Meta), Mutation-Guided LLM-based Test Generation at Meta, Proceedings of the 33rd ACM International Conference on the Foundations of Software Engineering (FSE 2025), ACM.
- Capgemini y OpenText, World Quality Report 2025: AI adoption surges in Quality Engineering, but enterprise-level scaling remains elusive, 13 de noviembre de 2025.
- Ouédraogo et al., Prompt engineering in LLMs for automated unit test generation: A large-scale study, Empirical Software Engineering, vol. 31, artículo 103, Springer, marzo de 2026.
- AGENTS.md, sitio oficial del formato.
- OpenAI, OpenAI co-founds the Agentic AI Foundation under the Linux Foundation, 9 de diciembre de 2025.
- OpenAI, Reasoning best practices.
- Anthropic, Best practices for Claude Code.